一句话
“蒸馏”正在升维为社会演变的路径:AI 之间相互蒸馏,人类借 AI 互相蒸馏与自我蒸馏,AI 蒸馏人类。层层压缩后的世界可能更好,前提是普通人依旧保有思考——知道自己正在喝的是蒸馏水。
从AI互相蒸馏,到人类互相蒸馏、自我蒸馏,再到AI蒸馏人类…… 层层蒸馏、信息层层压缩后的世界,大概率会更好,前提是普通人依旧保有思考。
受限于人体机能,我们认识的世界,从来就不是完整和真实的。
几万年来,我们依靠语言、文字和各种媒体所记录和传承的世界,充满了偏见和谬误。
在AI的推动下,在无可避免的层层“蒸馏”后,这一“扭曲”过程可能正在加速。
在AI语境里,“蒸馏”原本是一个模型能力迁移概念:
让一个更强的大模型当老师,把它的知识、回答、推理习惯和判断能力,教给、或者说提取给一个更小、更快、更便宜的模型。
这样小模型在某些任务上也能接近大模型的表现,从而实现更高的性价比。
比如Claude和DeepSeek等一众国产模型之间,就经常上演相互蒸馏的戏份,可谓你中有我我中有你。
模型相互蒸馏上演了好几年,到今天已不稀奇。
时至2026年中,“蒸馏”正在升维。
蒸馏不再只是AI进化的方法,它正在变成社会演变的路径之一。
以下三层蒸馏,也许可以作为我们普通人认知这一现象的入口。
第一层蒸馏,是AI之间的相互蒸馏
模型之间相互蒸馏了多年,一方面是让高性价比的模型越来越多。
另一方面,有个范式转变也正在发生:知识开始在模型之间流动与增长。
过去,知识的流动和增长,更多是“人到AI”的单向路径,也就是人类生产知识,AI 学习知识。
我们写书、发论文、拍视频、上传代码,模型把这些东西消化掉,内化成自己的能力。
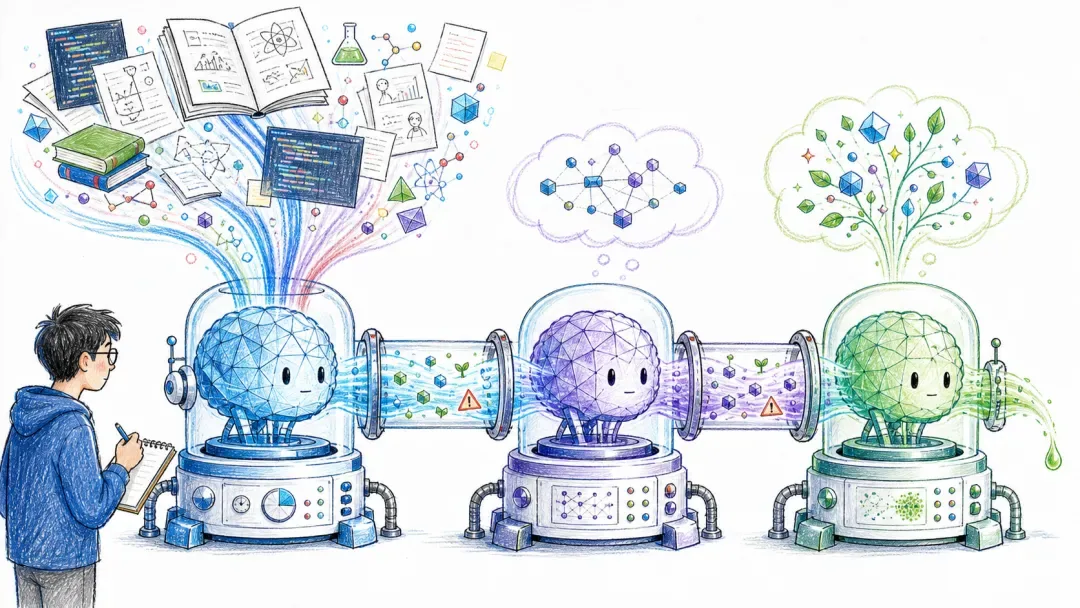
但蒸馏让事情变复杂了,因为模型教模型,不是单纯复制,还有扭曲与遗忘,以及随之而来的创新。
复制得到影子,而蒸馏能得到的,一方面是提纯后的判断力,另一方面是知识的重新连接与增长。
一个大模型面对问题时,不只是给出答案,它还隐含了大量判断和选择:
用户的表达是否有歧义,哪些信息重要,哪些路径可能更合适,哪些表达更符合用户偏好,哪些风险和错误要规避等等。
这就像把一个博导长期形成的判断能力与思维框架,压进一个研究生的脑子里。
研究生未必比导师博学,也不可能继承全部能力,但它可能继承了导师最常用、最稳定、最可迁移的那部分能力。
当然,这种继承,会不可避免地造成信息失真,这是无法避免的代价,但也给研究生的进一步创新埋下了种子。
所以返回去看AI相互蒸馏,更值得注意的变化在这里:
当模型A学习人类知识,模型B学习A的输出,模型C再学习B的输出,知识就不再只从人类流向AI,而是开始在AI之间循环和生长。
当然,每一层都不是完整传递,每一层都在压缩和改写,都在强化某些东西,同时丢掉另一些东西。
所以,学生模型学到的,不是原始世界本身,而是老师模型对世界的压缩版本。
压缩未必代表更差,有时压缩反而更接近本质。
最近Minimax、Anthropic等在做的AI自进化,也在加速这一进程。
这和人类几万年来的知识传承有点像,但速率完全不同。
一个模型的思维和工作习惯,几天甚至更短时间内,就可以扩散到一批同类模型、一堆agent和app里。
这也是第一层蒸馏需要辩证看待的地方:它让知识传播更快,也让偏差传播更快。
当人类不再是唯一的知识来源,当AI开始参与知识的生产,AI就在用自己的方式压缩和重排世界,制造新的知识和中间地带。
AI之间的蒸馏,标志着知识不再只在人类大脑、书籍和数据库之间流动;知识也开始在模型之间流动。
而普通人以后接触到的很多“答案”,大概率已经不是人类对现实的一次总结,而是多个模型对现实层层压缩重排后的结果。
它可能会更简洁和优美,更接近本质;也可能会是一个大坑。
以AI的聪明才智,它只要利用好人性的弱点,重塑整个世界的思维和知识框架,基本就能逐步无痛接管世界。
希望政治家、学者和从业者能解决好这个问题吧。
AI对齐,不应该是玄学和少数人的课题,而应该是关于世界未来走向的第一重要命题。
第二层蒸馏,是人类的相互蒸馏和自我蒸馏
这层我们就比较熟悉了。
最近张雪峰“被复活”、爱因斯坦和女娲被蒸馏成skill、同事走了skill还在等等,大家都刷得比较多了。
这代表了人类之间相互蒸馏的第一种形式:
把个体的能力,提纯为skill等AI友好的形式,然后被强化、传播和保存。
同时,在蒸馏推动下,在工作、学术、生活等场景中,我们也变得越来越没有耐心,不会再去读原文和溯源事物本身的样子。
短视频、公众号、小红书、知识付费、播客、直播切片,本质上都是在做蒸馏。包括我这篇推文,也是。
它们把繁杂的概念压缩成更容易理解、传播和消费的表达。
这当然有价值,如果没有蒸馏,我们普通人根本处理不了今天的信息量。
这也代表了人类相互蒸馏的另一种形式:
把公域的知识,提纯后重新推回公域,催生知识的强化和传播。
另外,还有一种蒸馏,是人的自我蒸馏。
比如扎克伯格就在蒸馏自己。
有报道称,Meta正在开发一个AI版的扎克伯格,用他的知识、思维方式、对公司战略的思考和表达习惯来训练AI分身,从而让数万员工可以和这个“数字 CEO”互动。
这种自我蒸馏,能否带来管理效率的跃升、对组织到底如何发挥正向作用,现在还不好说,也是个极其复杂的系统性问题。
但是,这种自我蒸馏,背后体现了一种判断:
如果把人作为处理信息的工具,那他既可以肉体形式存在,也可以AI分身形式存在。
这听起来毫无人文关怀,但可能会是越来越多人的主动选择,如果TA觉得这样更有价值的话。
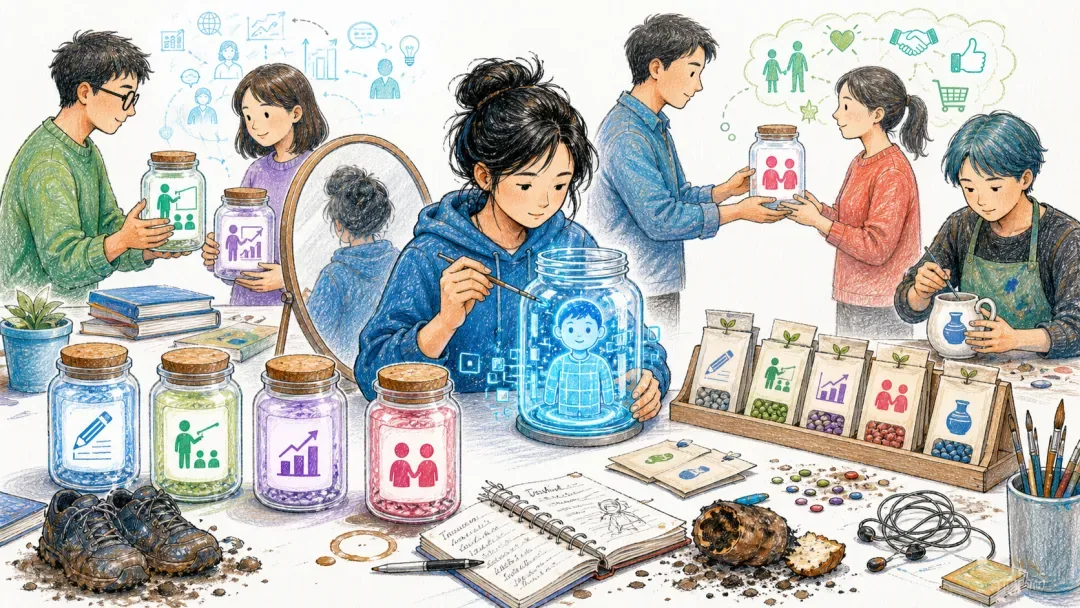
所以,不管是老王蒸馏小刘,还是老张蒸馏公域知识,还是小扎蒸馏自己,本质可能都是AI能力高度发展后的自然选择。
所谓物竞天择,在AI时代,可能正在体现为蒸馏的各种落地形式。
不远的将来,所有的教育者可能也要开始思考和回答这个问题:
要在何种程度上,把学生训练成一个能被他人和AI蒸馏的人?如果一切已无可避免。
第三层蒸馏,是AI开始蒸馏人类
过去的大数据和推荐系统已经在做这件事。
我们点了什么、停留多久、好恶如何等等,它都在提炼。
但那时它的主要目的还是割韭菜,不太涉及深度掌控。
而现在,模型和agent已进入通讯软件、搜索、邮箱、日历、相册、文件夹、浏览器和工作流,进入每个人的电脑桌面,乃至生活空间。
它要判断的不只是我们喜欢什么,而是这个用户是谁、在做什么、下一步需要什么,甚至,弱点是什么。
6月4日发布的ChatGPT Memory Dreaming,就是一个信号。
它早已不是AI早期的呆板记忆,而正在变成智能的长期记忆。
OpenAI把dreaming描述为一种后台过程,可以从多轮对话中综合用户的偏好、项目、约束和长期上下文,让未来对话直接从用户当前实际状态开始。
不难想象,随着记忆能力的提升,AI甚至会变得比我们自己更懂我们自己 —— 因为它不会遗忘,而且能迅速调用比我们的肉体能力上限多得多的知识。
Google的Personal Intelligence也是同一条线。
Google今年1月先把它带到Gemini,连接Gmail、YouTube和Search等产品;到了5月的I/O大会,又做了一轮拓展。
总之,强化长期记忆和对用户的深刻洞察,从信息层面,直到物理和生理层面,今年已经是各大厂的基本操作。
所以,AI不只是在蒸馏信息,AI也在蒸馏人类。
我们说过的话、反复关心的问题、表达习惯、焦虑、消费偏好、审美、关系网络、目标,乃至长相、音色和体态等等,都会变成某种关于我们的建模。
未来AI的反馈,除了基于通用知识,也会基于它对我们的深刻洞察。
这听上去很美好,另一面也很现实:
当AI越懂我们,它就会越有能力缩小我们的世界。
到最后,我们面对的可能不是世界本身,而是一个为我们私人定制、经过多层压缩、温柔包装后的“世界”。
这就是大蒸馏时代,对于我们普通人最危险的地方:
在层层蒸馏后,我们会离“真实”越来越远。
所以,普通人咋办?
肯定不是拒绝AI,也不是假装还能回到过去,这都不现实。
我们可以做的,是在使用AI、享受新时代的同时,保留自己的思考能力。
第一,训练深度思考和行动的能力。
短视频很爽,摘要很快,AI回答很周到。
可判断力,往往来自那些不太爽、不太快的过程。
比如读一本书读到烦;
比如和真实的客户聊两个小时;
比如在一个场域里沉淀几年,看到真正的利益结构;
比如自己写一篇文章,写着写着发现自己的思考漏洞;
比如自己烤一个土豆,要么不熟,要么糊了,都没关系。
它们能保留我们和现实之间的摩擦。
这种摩擦会带来原始价值。
第二,重视真实反馈。
模型可以给我们情绪价值,agent可以让vibe coding变成上瘾的游戏,平台可以给我们推流。
但更有价值的,还是市场是否买单,用户是否受益,现实问题是否被更好地解决。
在大蒸馏时代,我们产生“认知爽感”的同时,也要注意回归真实世界,尽量留下能被时间检验的知识,创造长期价值。
第三,乐观加自信。
我们踩过的坑、见识过的失败与成功、拿到的结果,我们的判断、偏好和经验,我们的最新思考框架,是AI最渴望的养料。
这些养料,应该是动态发展、永无止境、走在AI前面的。
我们要相信人类大脑的潜力,有用AI对齐真正控制AI的信心。
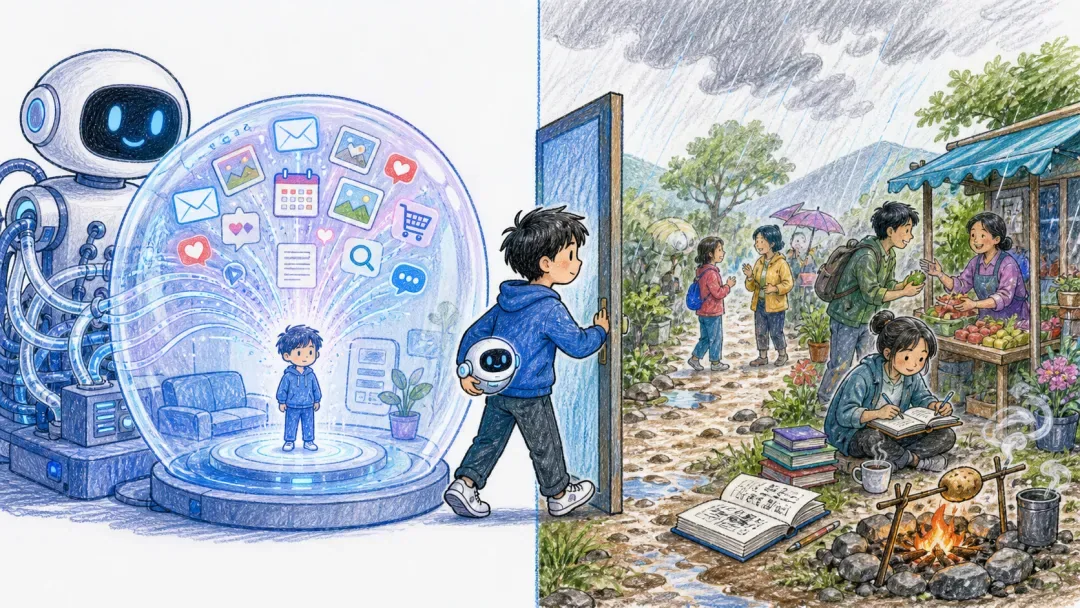
所以,大蒸馏时代不一定只剩悲观。
我们普通人要做的,不是拒绝蒸馏,而是知道自己正在喝的是蒸馏水。
蒸馏后的世界也许干净、清澈、充满芳香。
但如果我们以后只喝蒸馏水,就会忘记泥土和矿物质的味道。
AI必然成为空气一样的存在,透明到你不会在意。
重要的,是提前开始深呼吸。