» 这期有点长,建议收藏然后有空时“听全文”。
一句话
从 2026 Google I/O 看 Google 的转型:Gemini 正把搜索、安卓、Chrome、Workspace、云、TPU 和 DeepMind 串成从芯片到 agent 的完整 AI 堆栈——Google 在用 AI 从底层重写自己。
好久没写Google了,今天补上。
最近一年一度的Google I/O大会已经开完,用一个字总结的话是“快”。
这个“快”,主要体现在新模型Gemini 3.5 Flash上,日常问答体验下来,确实比GPT等一众主流模型快,有点真人互动的感觉了。
其他看点也不少,哈萨比斯也出来站台了,看得出目前AI头部竞争之激烈。
如果把这次I/O的东西和近期Google的操作放在一起看,会发现还有一个“快”:
Google正在从一家搜索与广告公司,快速变成一家由Gemini驱动的全栈agent公司。
以前Google的AI转型路线,总给人感觉不够清晰,新不新旧不旧的。
今年,Google开始把自己过去二十多年积累下来的资产 —— Search、Android、Chrome、Gmail、YouTube、Workspace、Cloud、TPU、DeepMind、开发者工具、科学研究平台等等,迅速串到一起。
过去,这些东西是Google这家巨型公司里的一个个山头;现在,Gemini正在变成中间那根线。
也就是说,Google正在用AI从底层重写自己。
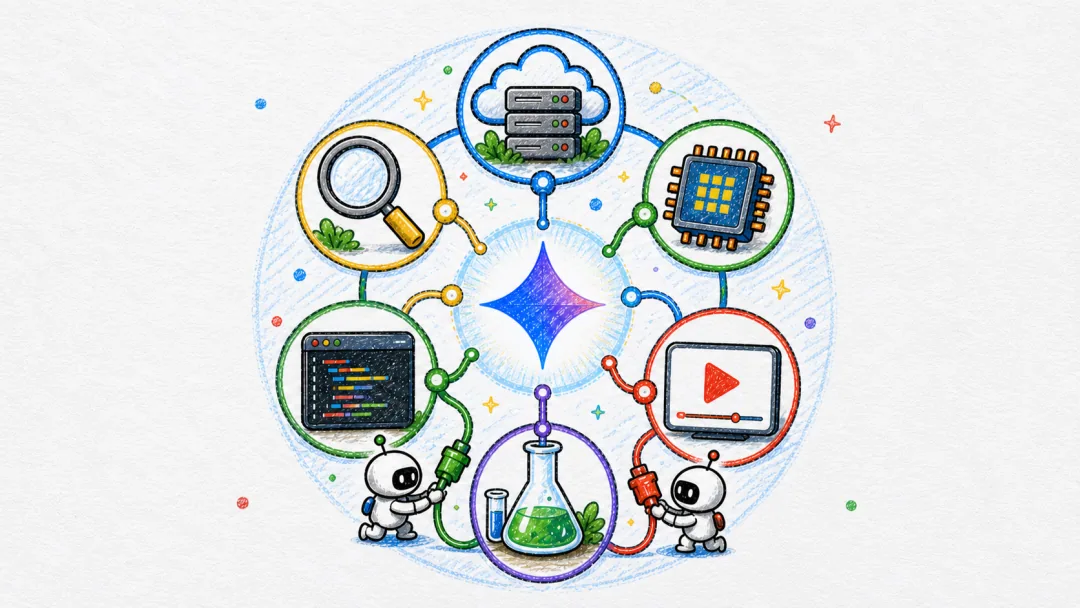
Google搞“全栈”
在agent时代,今年Google几乎所有重要发布,都可以放在这条线里理解:
Gemini 3.5 Flash,提供多快好省的主流模型能力;
Gemini Spark,由Gemini驱动的全天候个人代理;
Search Agents,让搜索从一次性查询变成后台持续监控;
Antigravity,让开发者可以调度一组agents去完成复杂任务;
Managed Agents,让开发者通过API就能创建云端agent;
TPU和Google Cloud,为这一切提供基础;
DeepMind和Gemini for Science,一方面探索AI for Science前沿,一方面反哺自家模型和agent能力提升,还有产品生态搭建。
以前的“一盘散沙”,正在被搭成一个完整的AI堆栈。
从芯片到模型,从模型到agent,从agent到搜索、办公、开发、科研、消费应用,再回到云和基础设施。
这就是Google的“全栈”。目前能搞这种全栈的,除了Google,其他可能也没谁了。
3.5 Flash变快,是因为agent时代必须快
先说大家最关注的Gemini 3.5 Flash。
我这段时间试下来,感受是真的快。
当然,很多其他模型也很快,比如国产的阶跃星辰Step系列,接龙虾的体感就很好。
重点是,3.5 Flash这次几乎实现了速度和质量的最佳平衡,没有那种因为“快”而变“傻”的感觉。
Agent时代,“快”变得重要,是因为agent需要在模型的驱动下,迅速完成理解目标、拆解流程、读取文件、调用工具、浏览网页、比较信息、生成方案、落地执行、检查结果、继续修正的agentic循环。
也就是说,用户一次输入的背后,可能有几十次,乃至成百上千次的模型调用。
这时候,模型必须快,必须便宜,必须稳定,否则agent就跑不起来。
如果每一步都很快,它就开始接近类似“后台同事”的感觉,这也是为啥flash这条线非常关键。
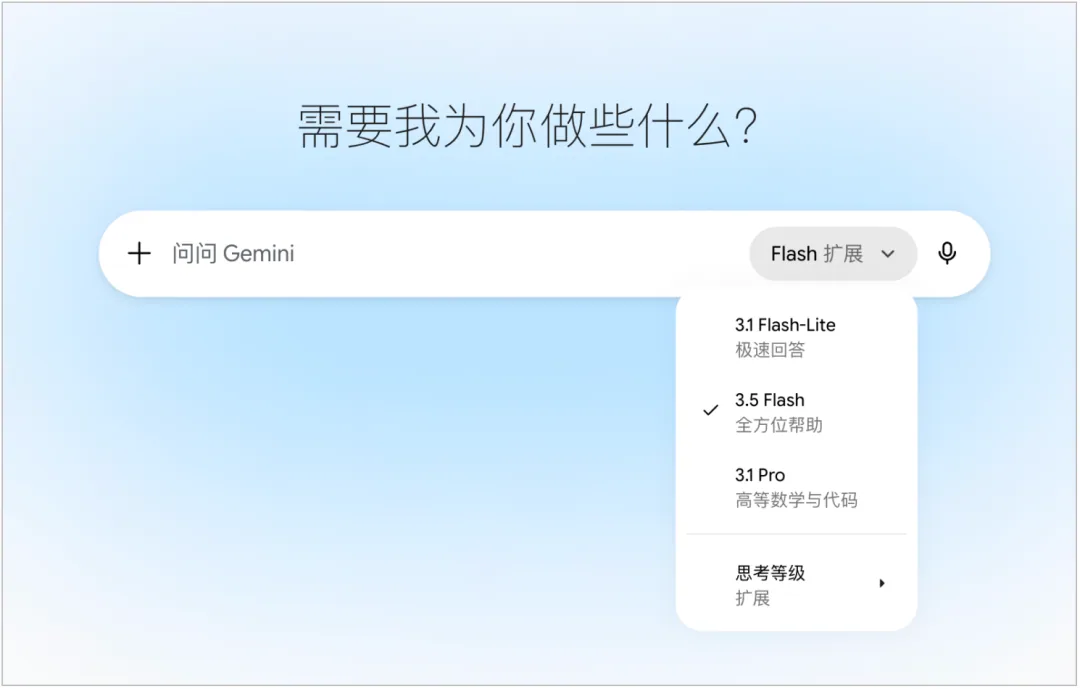
Pro代表能力上限,flash代表规模化普及。
Pro解决的是少数难题,flash解决的是每天发生千万次的普通问题。
下一阶段,更多进入普通人生活、企业流程和开发者工作流的,将从各家的最强模型,逐步切换到那个能力中等,但足够快、足够便宜、足够稳定的模型。
Gemini 3.5 Flash的定位,就是成为agent时代的默认发动机之一。
当然,论“聪明”,3.5 flash肯定比不上别家旗舰。
比如我问它成都某楼盘情况,其检索深度和准度明显不如GPT5.5,看下个月3.5 Pro有没有惊喜吧。
3.5 Pro没有马上发布:大厂对于“强”与“快”的平衡
这次I/O还有一个情况是,代表自家顶级智能的Gemini 3.5 Pro没有正式对外发布。
按照很多人的预期,Google应该在I/O这种年度大会上拿出最强模型,硬刚GPT和Opus。
但Google没这么做,它先把Gemini 3.5 Flash推到了台前。
而3.5 Pro,官方的说法是,已经在内部使用,效果有明显提升,计划下个月推出。
这个安排看起来有点“没放大招”,但反而说明Google现在对模型的理解,已经不是追求阶段性“最强”,而是更重视规模化应用。
Flash负责眼下,pro负责下一步。
Google可能正在用flash跑真实世界,用真实任务反哺pro。
这也是“Google自进化”的一个缩影:
不是先在实验室里造一个完美模型,再拿出来给用户试;
而是先把足够强、足够快、足够便宜的模型放进真实场景,让搜索、开发、办公、企业流程和个人agent产生海量任务反馈,再反过来推动下一代模型进化。
从这个角度看,3.5 Flash和3.5 Pro也许不是简单的大小模型关系,它们更像一个分工系统。
Flash负责规模化执行,Pro负责能力上限突破。
Search、Spark、Antigravity和Cloud负责提供真实任务场。
这套组合,也许才是这次Google I/O真正想展示的东西。
也就是一套让模型不断进入现实、吸收反馈、继续进化的系统。
Spark作为面向大众的agent, 值得一看
Spark这次值得单独拎出来说说。
它不是Google的龙虾,也不是Google Assistant的简单升级。
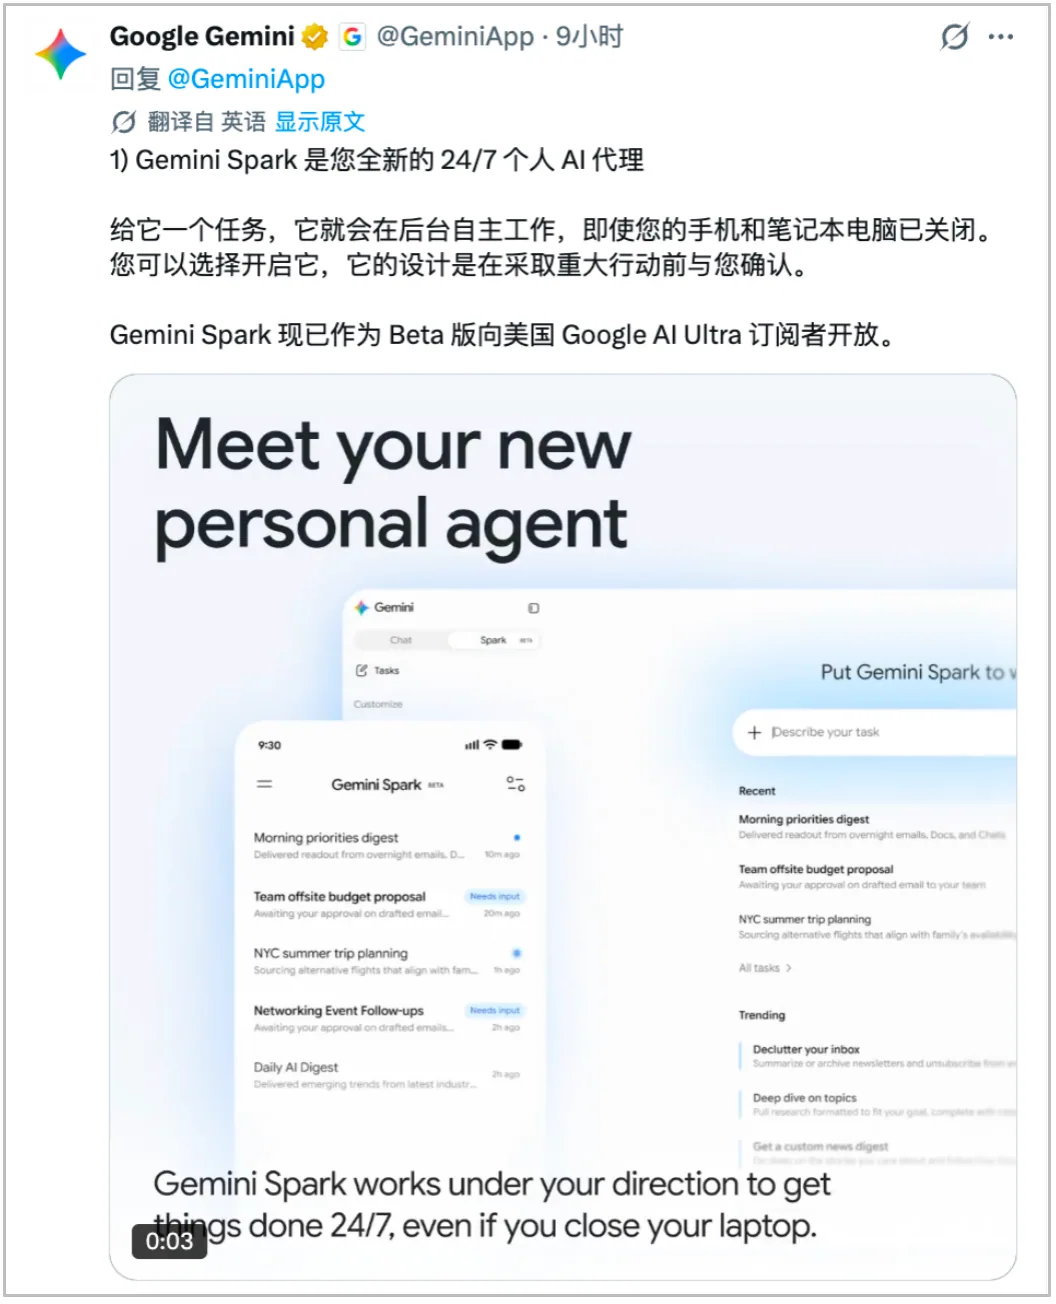
Google对它的定义是:24/7 personal AI agent, 一个24小时运行的个人AI代理。
意思是它不只是在你打开app后才响应的工具,而是一个可以在后台持续运行的云端智能体。
你不用一直开着电脑,也不用一直点手机,它可以在后台继续处理任务,手机锁屏了,电脑合上了,它也可以继续工作。
Spark更像是一个数字生活里的“后台小管家”,这样说有点土,但大概就是这个意思。
它可以帮你设置周期性任务,可以学习新的技能,可以创建完整的工作流,也可以和Gmail、Docs、Slides等工具打通。
也就是接管那些你不想做、但又不得不做的琐碎小事。
它运行在Gemini 3.5之上,也建立在Google Antigravity平台上。
可以这样理解:
Antigravity是开发者和专业用户调度agent的工作台;
Spark是普通用户使用的生活agent入口。
不过Spark现在还处在很早期的产品阶段,目前作为测试版面向美国的Ultra级用户推出。
这种产品和豆包还有千问app有相似之处,都是依托巨无霸平台向普通用户的日常渗透。
Search也不再只是搜索,而会变成agent入口
Google最核心的资产还是搜索。
今年I/O之后,“搜索”的定义加速演变。
最早,搜索是你输入关键词,搜索引擎返回网页列表。
后来,AI Overviews开始直接给你总结答案。
再后来,AI Mode让搜索变得像对话。
而现在,Google开始把搜索变成agent入口。
这次Google提到的search agents,可以让你在搜索里创建、定制、管理多个信息agent。
比如你在找房,不用每天自己刷。
你可以把预算、区域、户型、通勤、周边配套、偏好条件都丢给agent,它在后台持续扫描新房源,发现符合条件的再提醒你。
比如你关注某个运动员的球鞋联名,agent可以持续监控网页、新闻、社交平台和购物数据,有新动态就通知你。
比如你想订一个周五晚上的六人KTV包间,还要能供应宵夜,search可以综合价格、可订时间、位置、服务信息,给你直接可用的结果。
这些小功能,代表搜索正在从“找信息”变成“完成任务”。
过去,搜索组织网页;现在,搜索组织任务。
美团&点评:又学我!
其实仔细想想,“搜索”是何其重要的用户意愿表达:
我们每天搜百度、搜google、搜抖音、搜小红书、搜美团、搜点评、搜微信,背后都有真实的需求驱动,用搜索来驱动agent,确实值得搞。
等Google把卷子写差不多了,大概率我们就能在百度体验了。
Search里的mini apps,可能是生成式界面的雏形
Google也把agentic coding能力带进了search.
比如你问一个复杂的科学问题,它不只是给你文字解释,而是同时生成图表、模拟器、交互式视觉组件。
比如你想理解一个结构、一个概念、一个流程,它可以生成一个定制的可视化解释。
比如你想建立健康习惯,它可以直接帮你做一个持续使用的tracker,结合实时地图、天气、评论和本地数据,形成一个小型工具。
反正就有点学Claude的感觉。
Google把这类东西称为mini apps。
如果这个方向跑通,搜索引擎就会变得越来越像一个低门槛的应用生成器。
这其实有点接近“自然语言操作系统”的雏形了。
Antigravity是Google给agent时代准备的工作台
再往开发者,或者叫专业用户层看,强化Antigravity也是这次I/O的重要信号。
它会越来越像一个组织和管理agent的工作台。
这和Claude Code、Codex、Cursor大方向类似,不同的是,Antigravity背后的Google生态显然更强,想象空间也更大。
在agent迅速取代传统软件的时代,谁能让agent更稳定地执行长难任务,谁能给agent提供更好的harness、skills、工具、权限,谁能让开发者更容易地创建、调试、部署agent,谁就更接近产业链和价值链上游。
从这个角度看,Antigravity就是Google给出的答案。
它的多个应用场景中,science方向值得持续关注。
Omni,不只视频这么简单
Omni是这次多模态模型方向的一个亮点,官方说法是“It's like Nano Banana for videos”。
而且它还支持“Create from anything”, 也就是支持图片、文本、视频等多种形式的输入,想继续修改输出的话也是直接用自然语言就行了。
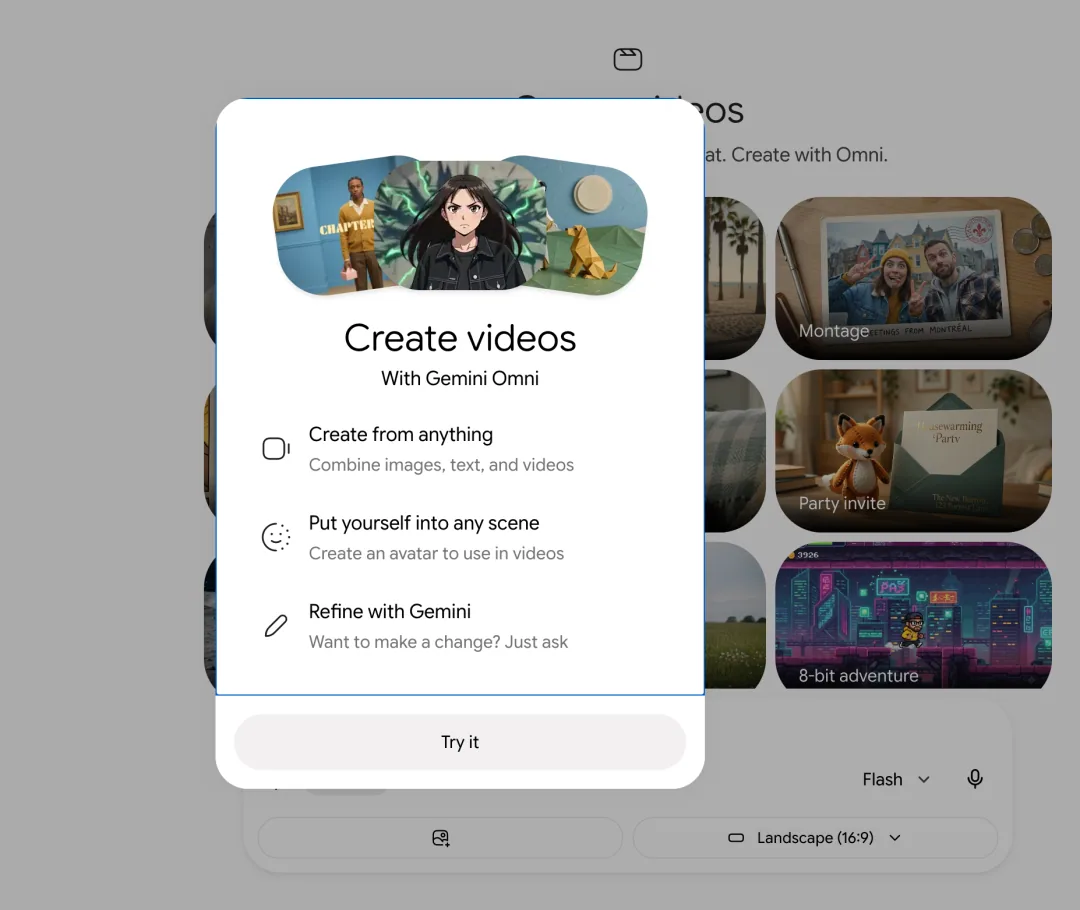
这种对于多模态输入输出的高宽容度,背后是“create anything from any input”的趋势,AI对世界和人类的兼容性都将越来越好。
当然,Omni现在主要还是做视频。
就像Seedance之于抖音一样,如果Omni进入YouTube生态,它的价值就会被迅速放大。
视频模型的可能性很多,既可以是一个“充分理解真实世界的AI剪辑师”,也可以是未来世界模型的雏形。
所以Omni不只是“Google也来卷AI视频了”,而是Google在往全模态agent系统走。
TPU:芯片在手,不是很慌
Agent需要大算力、低延迟和低成本。
Agent时代,越来越多的推理和边缘计算需求接入后,算力需求会很夸张,这也是为啥现在巨额资本都在砸算力砸芯片。
资本赌的是未来每个人都有几个、几十个,每家公司有成千上万个agent在后台运行,推理算力需求将出现爆炸。
所以Google的TPU芯片也值得关注,这次Google强调了TPU 8t和TPU 8i。
一个偏训练,一个偏推理。
训练关联模型能不能继续变强,推理关联AI能不能真正进入每个人的日常。
软硬兼备,这就是Google这种公司的优势。
这套体系如果运转起来,会形成从数据到模型到agent到硬件的内部良性循环,Google的自进化飞轮也就转起来了。
DeepMind和AI for Science,是大杀器
DeepMind是一个Google买来前沿实验室,也是一个不鸣则已,一鸣惊人的“大杀器”。
今年I/O上,DeepMind创始人哈萨比斯出来站台,本身就是一个信号:
Google要把Gemini放进更长远的AI for Science叙事里。
这次发布的Gemini for Science,核心不是帮科学家写摘要,而是让AI进入科学方法本身。
它主要包括几个方向:
Hypothesis Generation,用Co-Scientist帮助研究者生成、辩论、评估科学假设;
Computational Discovery,基于AlphaEvolve等系统帮助研究者探索和优化复杂计算方案;
Literature Insights,基于NotebookLM等工具帮助研究者理解、整理、比较海量文献。
这表明AI开始深度参与“提出问题—形成假设—设计路径—验证结果”的过程。
Co-Scientist尤其典型,它是一个多agent系统。
里面有负责生成想法的agent,有负责聚类和扩展研究方向的agent,有负责反思和批判的agent,有负责排序和辩论的agent,还有负责演化和整合最终研究建议的agent。
这就像一个小型科研团队,可以推进科学研究里那些复杂、漫长、反复的认知过程:提出假设、互相质疑、查找证据、迭代优化、筛掉不靠谱路径、保留更值得验证的方向。
科学研究中最贵的,往往是漫长的认知进步过程。
不知道该问什么问题、不知道哪条线索值得追、不知道哪些文献之间存在隐藏连接、不知道哪个方向可能浪费几年时间……
这些都会造成巨大的浪费。
如果AI能压缩这部分成本,科学进步的速度可能会发生明显变化。
DeepMind已经靠AlphaGO、AlphaFold、Gemini等等多次证明自己,未来它的想象空间还很大。
AlphaEvolve让Google“自进化”
AlphaEvolve是一个由Gemini驱动的agent,用来发现和优化算法。
它会生成大量候选方案,用自动评估器验证结果,再通过演化式方法,保留更好的方案,继续迭代。
比如优化数据中心效率、优化芯片设计、优化AI训练流程、优化数据库、寻找更快的算法等等。
也就是说,Google正在用AI提升自己的底层系统效率,实现所谓“自进化”。
现在Google试图形成的是AI时代的新增长逻辑:
模型提升工具、工具提升生产、生产提升基础设施、基础设施提升模型、模型再进入更多产品和场景。
这就是一个由Gemini驱动的技术代谢系统,也有点像一个巨型公司开始长出自己的神经系统。
过去是各个部门各跑各的,现在,Gemini在中间连接、调度、反馈、进化。
Google终于把自己的碎片资产拼成了一张网
过去几年,Google给人的感觉是,产品太多、技术太多、山头太多, AI路线也不够清晰。
随便拎一个出来都是顶级资产,但这些东西在用户心智里是长期分散的。
OpenAI聚焦GPT和Codex,Anthropic聚焦Claude和Claude Code。
Google反而因为太大,显得笨重,甚至有点乱。
但今年I/O之后,至少叙事上开始清楚了:
Gemini是核心模型;
Flash负责高频快速的日常;
Pro负责深度推理和复杂任务;
Omni负责多模态拓展;
Spark负责个人数字生活代理;
Search负责信息agent和任务入口;
Antigravity负责开发者agent生态;
AlphaEvolve负责润滑和加速自进化;
TPU和Cloud负责算力与基础设施;
DeepMind负责科学发现和前沿研究;
Android、Chrome、Gmail、YouTube则负责把这些能力嵌入普通人的日常。
渐渐地,Google可能会变成AI时代最大的那个入口和容器。
你可以从搜索进入它、从浏览器进入它、从手机进入它、从邮箱和文档进入它、从开发工具进入它、从云服务进入它、从科学研究进入它,甚至从一段视频、一个游戏进入它。
入口不同,但底层都是Gemini.
这也就是所谓“由Gemini驱动的全栈agent公司”。
趋势已经很清楚:世界agent化
当然,目前的Google,还是显得有点大而乱, 宏大愿景能否落地还得画个问号。
不管Google最终如何,世界agent化的趋势已经明确:
搜索会变成agent;
浏览器会变成agent;
软件和app会变成agent;
开发工具会变成agent;
云服务会变成agent;
科学研究会变成agent;
个人生活会出现Spark这样的24小时agent;
甚至所有操作系统和整个数字世界,都会变成agent。
坐拥这一切的Google, 应该已经意识到了这个必然结果,并在通过Gemini串联、加速这一进程。
过去大家总问:Google在AI时代能不能吃口热的?
后面也许更应该关心:
当Google下定决心用AI自我革命,规则和秩序全部重写的新世界何时到来?
AI必然成为空气一样的存在,透明到你不会在意。
重要的,是提前开始深呼吸。