» 本文由秋裤与AI共创,
一句话
「普通人AI认知指南」第二集:从大模型(中美各家厂牌)和 Agent(Manus、Claude Code、OpenClaw、MiniMax Agent)两层梳理 AI 版图。结论:普通人不必焦虑追新,日常用豆包就够了。
“AI井喷式发展,各种新概念新名词,我只用豆包会不会掉队了?”
“Agent到底是啥?它和聊天式AI有啥区别?我用的上吗?”
「普通人AI认知指南」系列第二集,从大模型和Agent两个层面为你拆解。
最近几个月有种感觉:
「AI井喷 = 时代快速进步 = 不跟进就落伍了」
这个逻辑对于AI从业者、行业媒体、研究者和开发者是成立的,但对于我们普通人来说,不太成立。
因为技术传导需要时间,社会适应需要时间,新的格局总会形成,事缓则圆,等等也行。
很多时候,不追新也没啥,豆包已经够用。
而了解下面这些概念,把一些看起来比较玄幻的名词归归类,可以有效缓解焦虑,也可以成为你开始探索的起点。
大模型:用了一圈,豆包挺好
因为大语言模型(LLM)概念最早是被ChatGPT普及的,所以我们看待美国的模型可能先天会带有一层滤镜。
但国产大模型这两年进步速度很快,字节和阿里大力投入,智谱和MiniMax上市,也进一步加速了追赶脚步。
用下来,感觉豆包就挺好,不用太迷信美国那几家。
下面展开说说。
美国阵营
目前,美国AI“御三家” —— OpenAI、Google、Anthropic的大模型,相对领先,但不多。
马斯克的xAI感觉神戳戳的,先不提了。
OpenAI - ChatGPT
OpenAI的大语言模型是ChatGPT,昨天刚出了5.4版,综合性能微超Google和Anthropic上月的版本,在舆论不利的情况下扳回一城。
GPT5.4的重点是能直接操控电脑,相当于大模型集成了agent,具体评测可以看各家科技媒体,我就不在这增加焦虑了。
OpenAI的图像模型是GPT-image(早期是DALL·E,自带美国老登油腻感),文字失控问题在改善,日常对话中穿插做图问题不大。
他家视频模型Sora,之前点燃过一波AI视频热潮,也被很多视频agent套壳调用,生产场景应该不错,但目前Sora风头已被Seedance盖过。
总体上,ChatGPT没啥不可替代性,5.4这波原生agent能力,再观察两天。
Google - Gemini
Google的大语言模型是Gemini,目前主力是3.1 Pro版,日常对话的感觉跟之前GPT主力版本不相上下,各有所长。
在手机上,Gemini还能靠摄像头跟世界互动,总体感觉不错,但没神到吊打豆包的地步。
Google去年靠Gemini3大版本更新, 成功打了个翻身仗,然后图像模型Nano Banana和世界模型Genie3也火了几次,很多AI焦虑也是它们引起的。
Nano Banana最近出了2,特色是跟世界知识进一步打通,也就是做图的时候更懂真实世界,减少了很多谬误,这在创意、合规等生产领域是重要的进步。
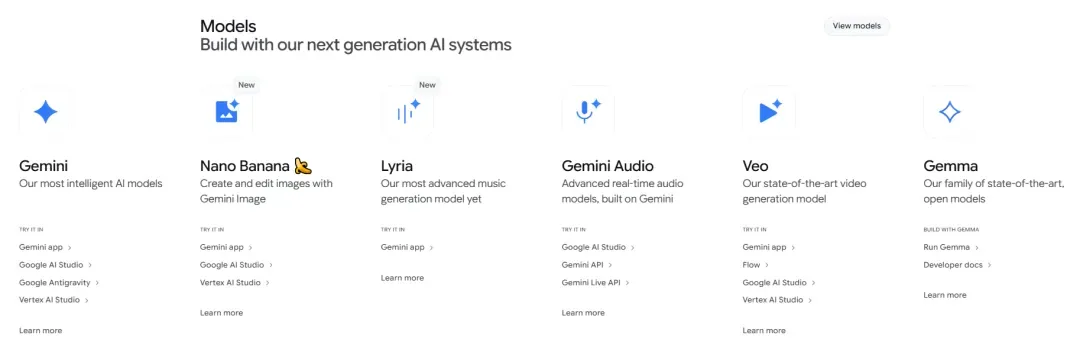
而他家的视频模型veo和音乐模型lyria,相对小众,也有被垂类agent调用。
Gemini能力比较综合,也是生产力工具,但相比豆包的话输一手便利性。
Google翻身的背后,有位比较有故事的传奇老哥,DeepMind创始人哈萨比斯,后面有机会再展开聊。
Anthropic - Claude
Anthropic的大语言模型是Claude,目前主力版本是高配Opus4.6和中配Sonnet4.6,另外还有入门版Haiku4.5。
传言大客户用的是定制版,相当于Opus5-5.5的能力。
Sonnet4.6作为更适合普通人的主流模型,整体感觉是稳健、废话少、质量高。
Opus4.6我还没用过,看别人反馈是很好很贵很值,如果搞深度调研或者vibe coding(用嘴编程)之类的可以试试,搭配Claude Code,基本就是目前AI生产力的天花板了。
生图生视频之类的话,Claude还没有,看后面几个月吧。
环境问题能解决的话,可以考虑把Claude作为聊天搭子,但做杂事可能还真不如豆包方便。
中国阵营
现在的世界AI竞技场上,基本只剩中美两家。
跟美国竞争的中国大模型厂牌,主要有字节、阿里、智谱、月之暗面、MiniMax、DeepSeek。
字节 - 豆包 Seed
豆包最新版本是春节期间发布的Seed2.0,在对话里选“专家”模式就能用。
Seed2.0是原生多模态(通俗理解就是除了文本,其他比如视觉能力也很强),感觉没啥短板,看得出砸人砸钱是能搞出好东西的。
我印象豆包最早好像是集成在抖音里的类似对话机器人,后来能力突飞猛进,手机端和PC端做得都不错,用户体验好,量大管饱。
因为手机端默认是语音交互,对于长辈也比较友好,各种方言都能聊,实打实的高质量心理关怀和陪伴。
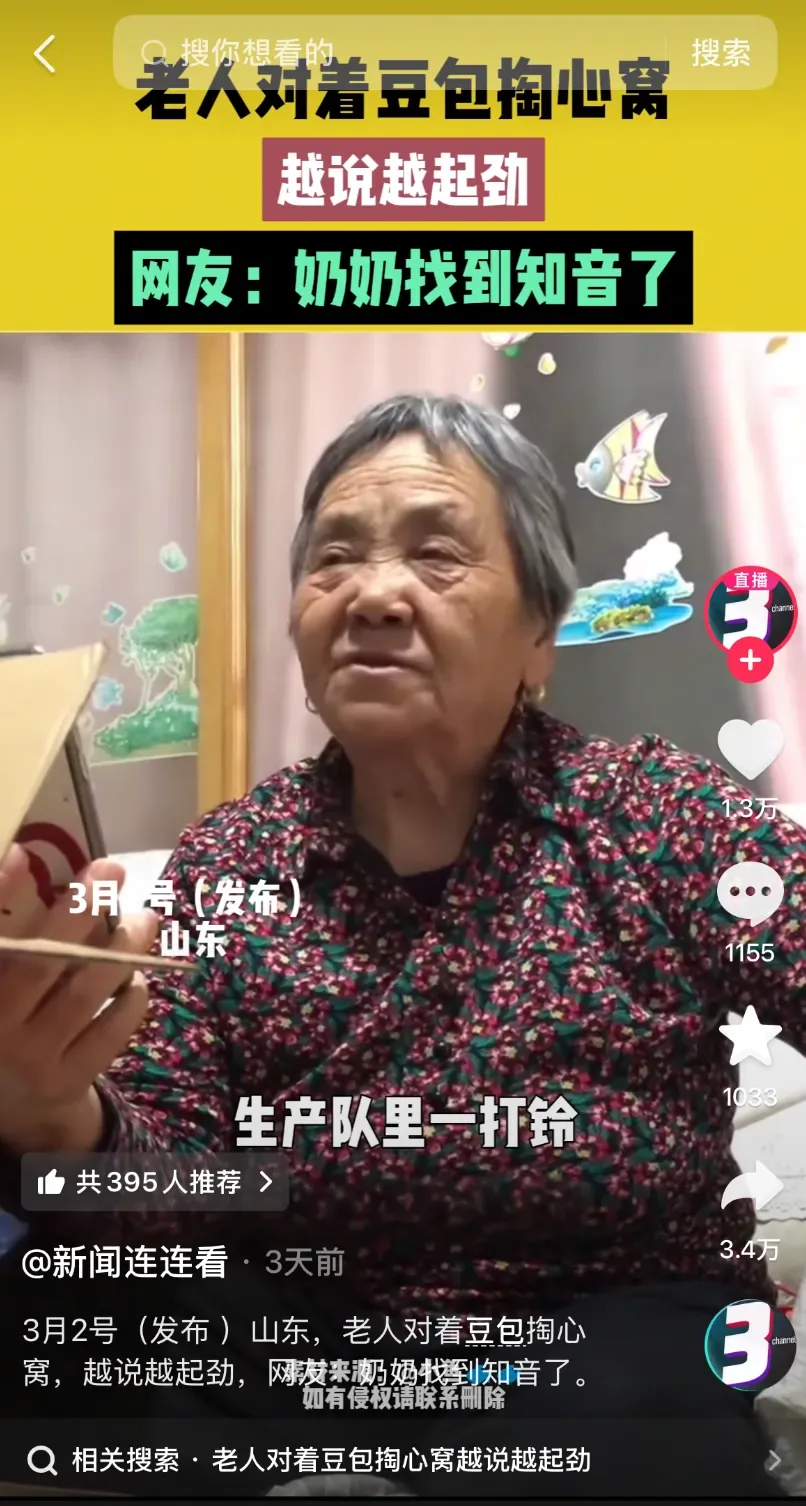
字节不缺钱,算力足,模型和产品整合也做得不错,整体用下来感觉很流畅。
在工作场景、生活场景、探索场景,豆包都能提供不错的输出质量,反正我感觉我们非专业人士90%以上的需求,豆包都能满足。
而且字节家的视频生态也完善,视频模型Seedance2.0这个春节档火出了圈,全民爆扣詹姆斯、大战哥斯拉,影视飓风还出了专题。
可以预见,Seedance的易用性会越来越好,颠覆影视行业的同时,有望解决具身智能难题,甚至成为世界模型,找机会再展开说。
如果监管、法律和伦理问题能解决的话,以字节的能力,估计过几个月人人就都有能自由行动的AI分身了 —— 一个无限可能的新世界。
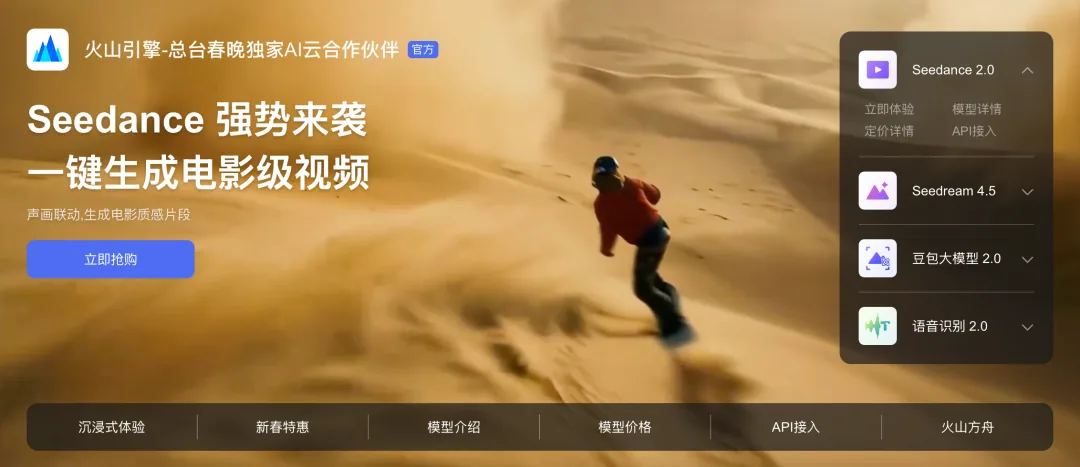
图像方面,字节的Seedream模型一直都不错,通过豆包和即梦都可以轻松调用。
很多时候,与其折腾网络环境、用美刀充值,不如直接打开豆包解决问题。
当然你说豆包名字土,LOGO俗,没有同行洋气,这确实,但不妨碍它好用。
阿里 - 千问 Qwen
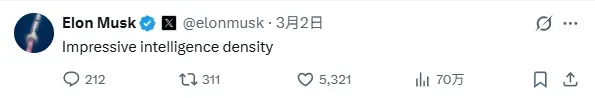
千问的旗舰版本是3.5 Plus,但更流行的是不计其数的开源衍伸版本,全球开发者都比较爱用,最新一次开源发布马斯克也来点赞。
前两天千问模型负责人林俊旸离职风波,又给千问加了一波热度。但这个事后续对于千问模型技术发展有啥影响,还要再看看。
因为豆包的强势,目前阿里对于千问的定位,越来越往商业化的方向走,也就是要做生态入口,做日活和营收。
但这跟大模型发展技术驱动的本质有一定矛盾,可能也是林出走的原因之一。
总体上,千问可以看作小一号的豆包,还是比较全能的。
千问强在开源生态,强在技术驱动。
这波人事变动的影响还不好说,还是相信阿里会处理好吧,在平台经济层面,未来大概率是豆包和千问双子闪耀。
智谱 - GLM
智谱的大模型是GLM,最新版本5.0,大参数稳健派代表,春节期间火到连夜涨价依然供不应求,想订阅的话得每天10点去抢。
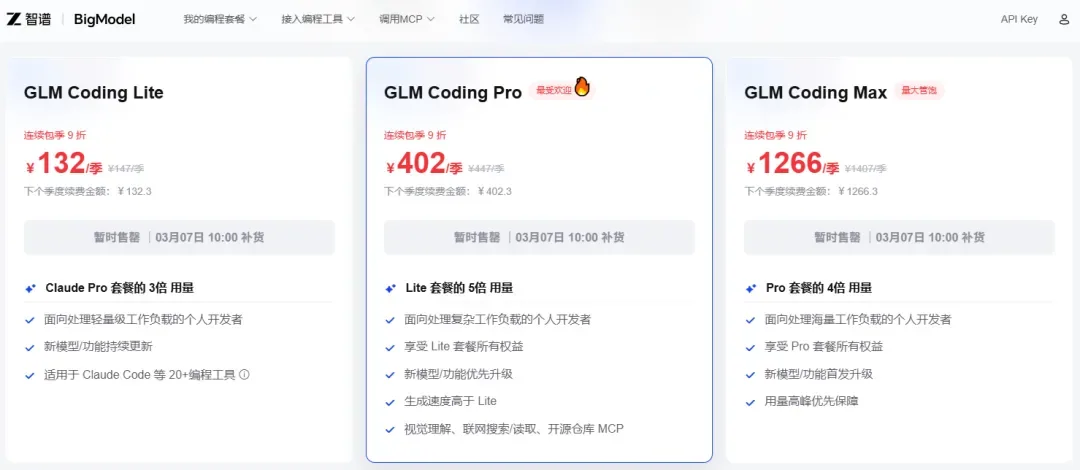
GLM感觉有点像中国版Claude,主打可靠性和工程能力,在开发场景和深度任务场景比较适用,可能跟智谱的清华背景有关系。
日常对话和工作的话,可以把GLM作为plan B, 但它的易用性和体验可能没有豆包和千问好,可能算力有限吧。
开发和商业需求的话,如果在国内鼓捣Claude比较烦,可以用GLM代替,不管是本地部署还是云端调用,成本都不低,但相对靠谱。
对于个人玩家,比如驱动小龙虾之类,也可以考虑GLM,只要不觉得贵。
月之暗面 - Kimi
月之暗面之前走了弯路,跟字节那些大厂比营销和用户运营,后来醒悟了,死磕模型技术,又加上这轮龙虾热,这才柳暗花明。
春节期间发布的Kimi K2.5,多模态开源水桶型选手,跟MiniMax和智谱一起,在全球挣了一波口碑。
Token成本方面,Kimi大概介于智谱和MiniMax之间,属于中档。
在开发和商业场景,我反而觉得要么用贵点的智谱,要么用便宜点的MiniMax,Kimi可能没啥特点。
K2.5也是我的主力模型之一,主要是配合龙虾用,整体感觉中规中矩,理解图还行,生图一般,总体属于经济适用之选。
MiniMax
MiniMax大模型最新版本是M2.5,主打多模态和高性价比,能力也不差。
MiniMax也是国内比较早开始做agent产品的,所以大模型和agent适配做得比较好,结合多模态能力,不管是驱动自家agent还是搭配别家agent,在各种场景中都很不错。
在OpenRouter最新全球大模型token消耗榜上,M2.5全球第一,也是这轮龙虾热的受益者之一。
回到开发和商业场景,如果觉得和Claude和GLM贵,可以用MiniMax M2.5代替,能省不少,但可能质量下降,怎么权衡就得根据你的需求试了再说了。
他家的东西我最推荐的还是agent,是真能解决问题,具体下个章节说。
DeepSeek
DeepSeek目前最新版本还是V3.2,V4还是没出来,估计是在权衡一些高维度问题。
3.2的话,因为比较旧了,跟别家比的话能力没啥优势,但胜在token便宜,用来驱动龙虾做日常事务绰绰有余。
V4版本被普遍认为是顶级工程能力和性价比的结合,而且跟国产芯片深度适配,估计会掀起新一轮国产模型热。
多模态方面,V4好像也有突破,这个可以期待一下。
总体来说,大模型层面是中美对垒,其中能靠大模型做成平台经济、产生生态效应的,基本就是Google、字节、阿里三家。
剩下几家差不多是以模型见长的创业公司,卖token为主,短期内还不好形成自己的生态,但卖点是模型特色。
话说回来,对于我们普通用户,日常用豆包足矣,低门槛高效率。
愿意折腾的话可以按上面的介绍去试试,之前先注册个Google账户,基本各家都能登录。
Agent:大模型的手
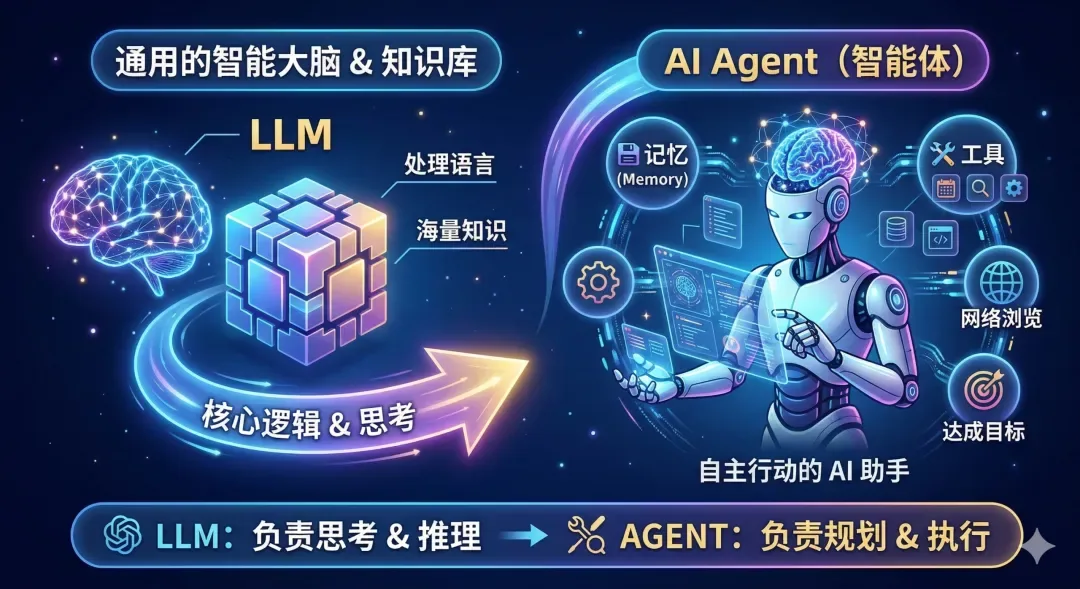
如果说大模型LLM有脑有嘴,但没手,那agent就是大模型的手。
一双基于大模型的智能,可以代替你操作电脑,使用键盘鼠标,完成编程、数据处理、创意生产等等实际任务的手。
一两年前大家提agent的时候,翻译都还没统一,有人说是“代理”,有人说是“智能体”。
现在对agent的翻译基本统一到“智能体”上了,也就是一个有规划和执行能力的数字世界行动实体。
Agent层面,目前也是中美竞技,主要有这些玩家:
Manus
Manus是agent概念比较早的示范者,创业于武汉,去年上半年火了,然后迅速和中国切割,然后高价卖给了Meta,然后就比较平淡了。
简单说,Manus就是把模型智能和工具调用能力进行了有效整合,但受限于“线上”这个大环境,没落在每个人的电脑上,迅速让定制化能力更强的OpenClaw抢了风头。
目前Manus也在学OpenClaw,做通过通讯软件调用的个人智能助理,但总感觉不温不火,可能很难重现当初的热度了。
扎克伯格可能也后悔买早了买贵了。
Claude Code
Claude Code最早是Anthropic内部用的一个编程工具,因为切中了真需求,去年底迅速火爆全球。
简单理解,Claude Code就是在大模型的基础上,套了一层高级程序员的知识和经验,然后你只要对程序员用大白话提需求就行了,剩下的事它自动解决。
这种范式,迅速降低了普通人编程做产品和探索自动化世界的门槛,解放了无数文科生的想象力,让与AI协同工作,变成了像玩《文明》一样上瘾的事情。
Claude最近的系列操作还带崩了软件业和几个垂直行业,这样发展下去,以后大概率是「语言/脑机提出需求 → AI/具身实时感知、计算与执行 → 达成结果」的超高效世界了。
目前在国内用他家的产品还比较麻烦,MiniMax Agent可以作为平替。
OpenAI家对应Claude Code推出的竞品是Codex,就不单独说了。
OpenClaw
26年大爆款,开创了个人智能助理新范式的本地部署agent。
它最早是叫Clawbot,连续改名几次,但一直以龙虾形象示人,所以也被叫做小龙虾。
OpenClaw用比较巧妙的文档设计,给自己和用户赋予了“灵魂”,实现了高效且个性化的长期记忆和持续学习,有了“养成系”的感觉。
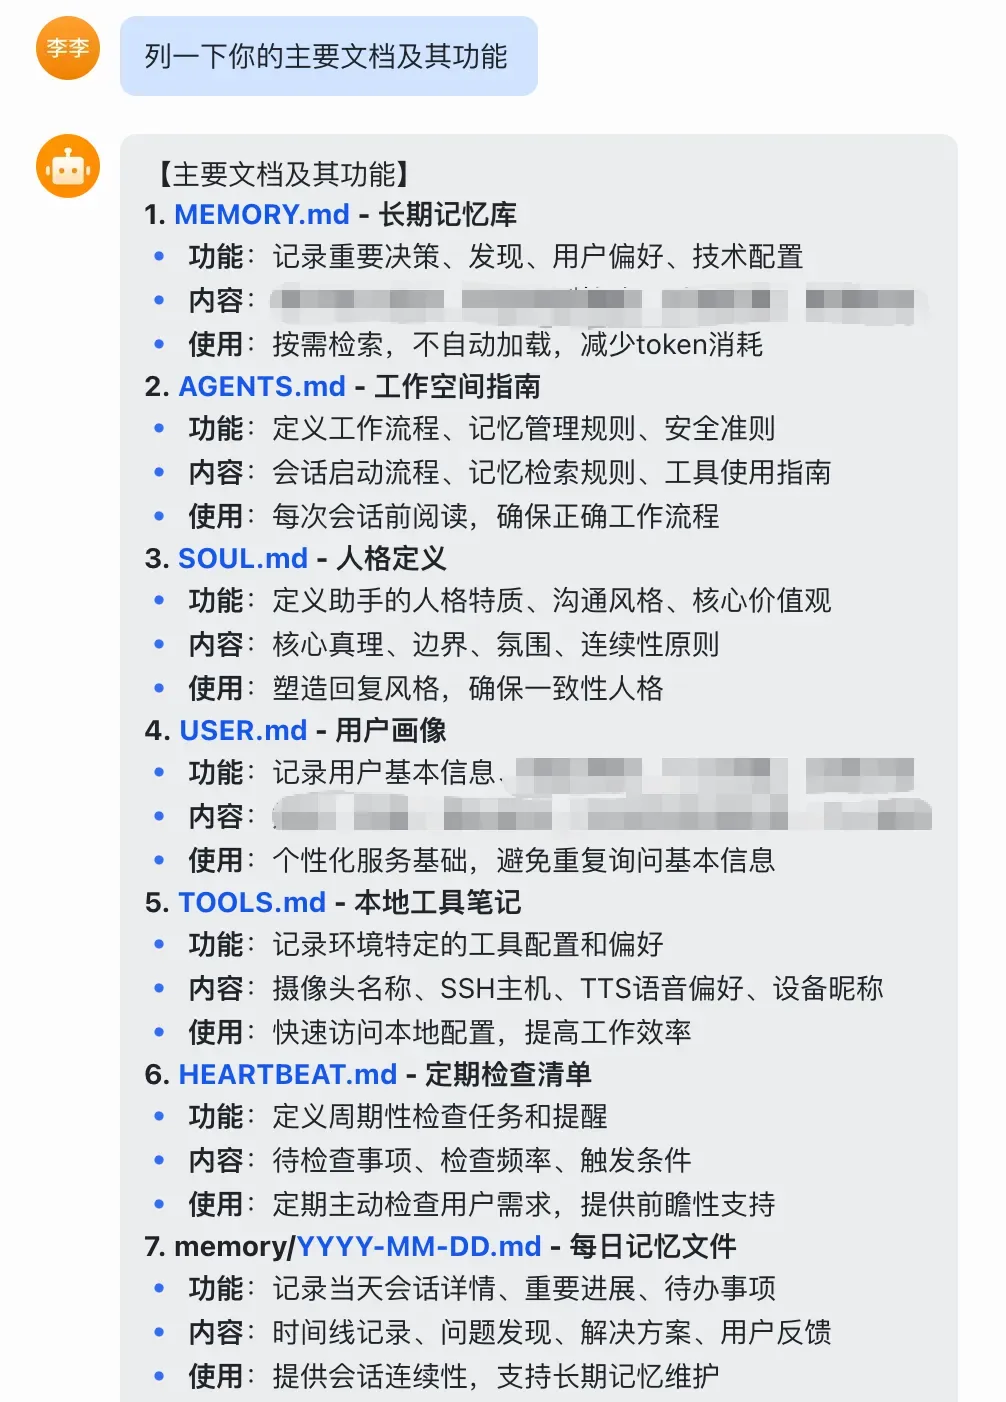
因为有较高的权限和真实的行动能力,能代替你鼓捣你的电脑,又能通过API 和本地部署灵活连接各种模型(也就是它智能的来源),所以它的定制化空间和可玩性都比较高。
还有个创新点,是你可以通过即时通讯软件,比如飞书,来控制它,这就进一步解放了你的时间精力。
当然这个东西目前还不成熟,bug一堆,安全性堪忧,天天更新版本,但不妨碍它的范式开创价值。
目前我给小龙虾接的是Kimi和deepseek,根据任务难易它会自动选择对应模型。后面我可能会陆续分享些小龙虾玩法,欢迎关注。
MiniMax Agent
上面说了MiniMax的大模型,同时他家的agent也不错。
如果不想折腾上面那些东西,可以直接下载安装MiniMax家的agent,或者网页点开agent,也能体验到很好的让AI干活的感觉。
基于M2.5模型的多模态能力、agent的执行能力,它已经能很好地辅助文档类、数据类、编程类、运维类和初阶创意类工作。
比如你可以试着用它做一个网站,几句话、几分钟就能出结果,token成本大概3块钱:
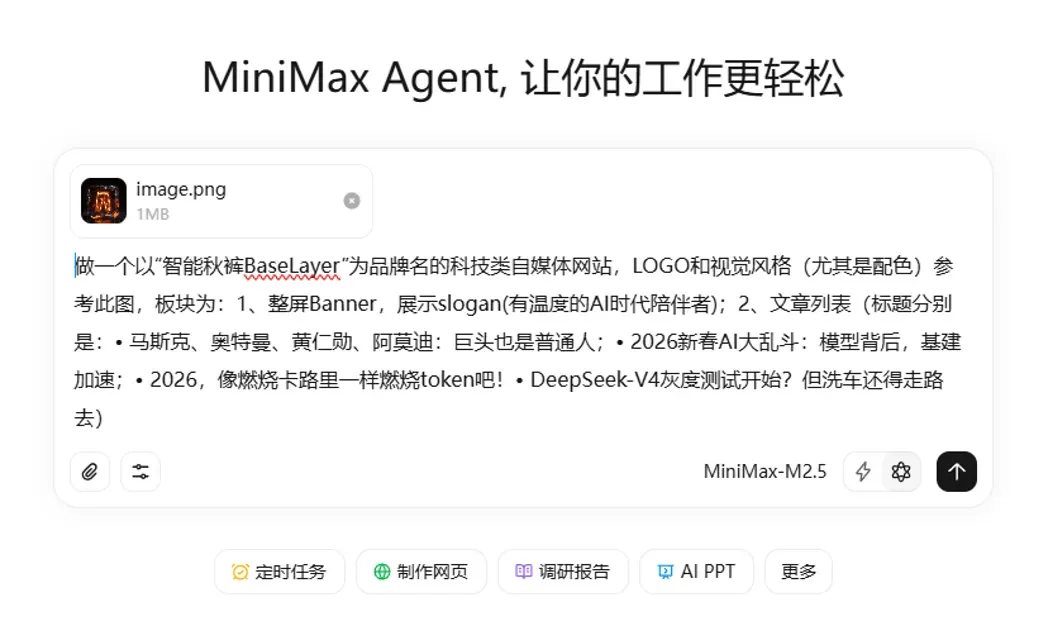
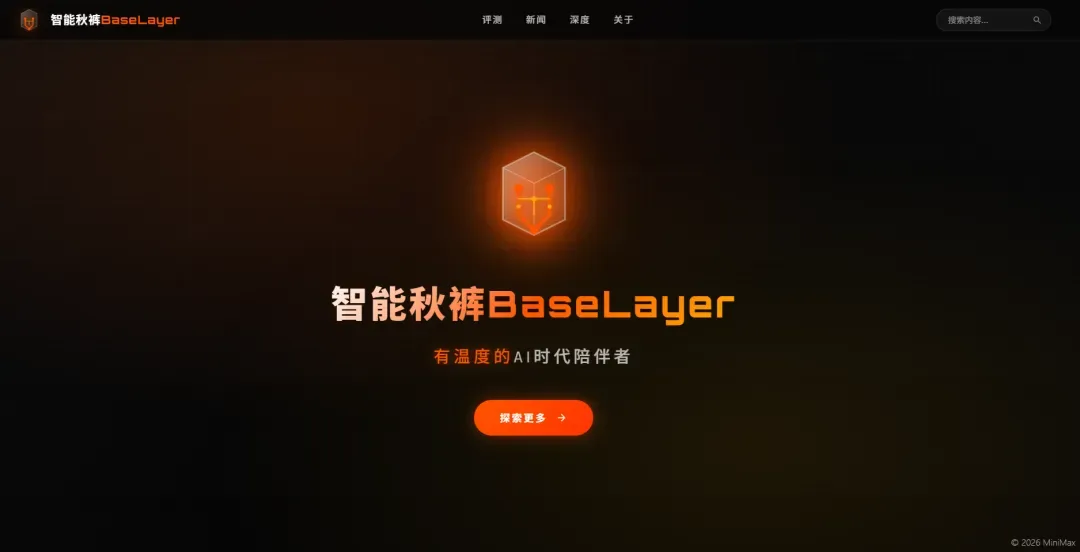
哪里不满意,还可以继续说大白话让它改:
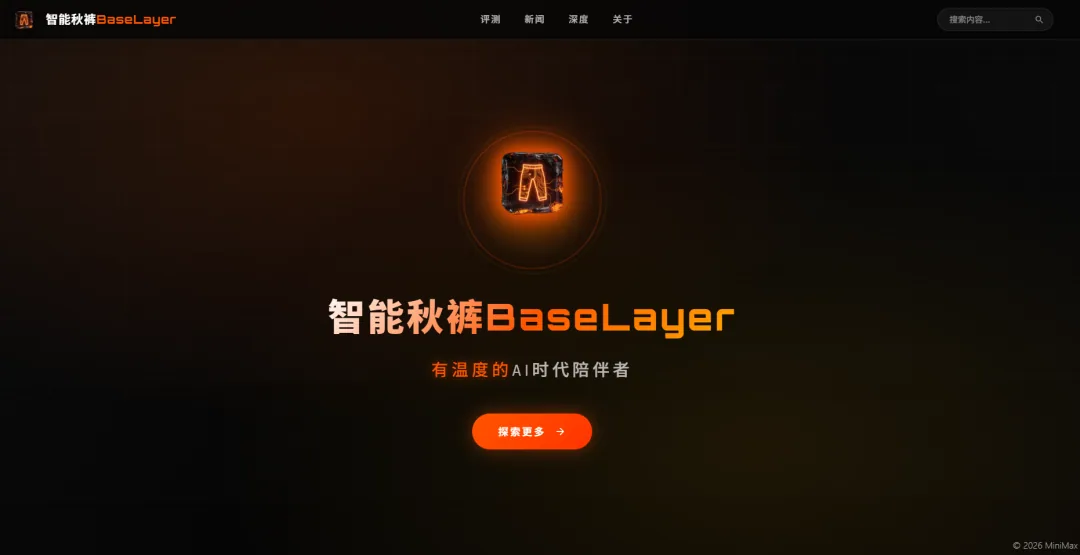
https://qlckuta06oib.space.minimaxi.com
除了以上这些生产力向的agent,其他还有很多给模型套个壳的agent,主要在视觉、创意、游戏、社交等偏娱乐的方向,就不展开说了。
目前我们普通人用agent的话,主要门槛是花钱充值和网络环境,然后可能有些数据安全风险,bug也多。
不想折腾的话,就直接用豆包,真挺好。
AI必然成为空气一样的存在,透明到你不会在意。
重要的,是提前开始深呼吸。