一句话
实操:用 ChatGPT 做策划,用 MiniMax Hub 和 Seedance 出片,做了一支“秋裤跑酷”短片。核心工作用高配模型、非核心工作用中低配模型的“人肉模型路由”很划算;AI 视频正从娱乐走进电商、培训等工作流。
这两天Seedance2.5和MiniMax H3挺火,视频方向的玩法也多起来了。它们落地应用的趋势,也是在从娱乐场景向工作场景延伸。
也就是视频模型不再只是自媒体工具,而是开始批量进入比如电商、产品演示、功能说明、培训、讲课,甚至训练数据生成领域,成为流水线上的一环。
一方面,前沿视频模型的能力已经达标,另一方面,价格也在降,再结合目前很成熟的agent框架,就能迅速进入打工人的日常。
比如MiniMax新出的MiniMax Hub,作为类似腾讯Miora的多模态创意类agent,就把模型丰富度和交互易用性做得挺好,我就拿它做个了秋裤跑酷短片:
此处原文有一段视频,可前往公众号原文观看。
大概分两步:
ChatGPT做策划
做视频的第一步是文案,也就是策划这部分工作。之前最简单的方式,就是在聊天框里,跟AI直接把这些内容聊出来。
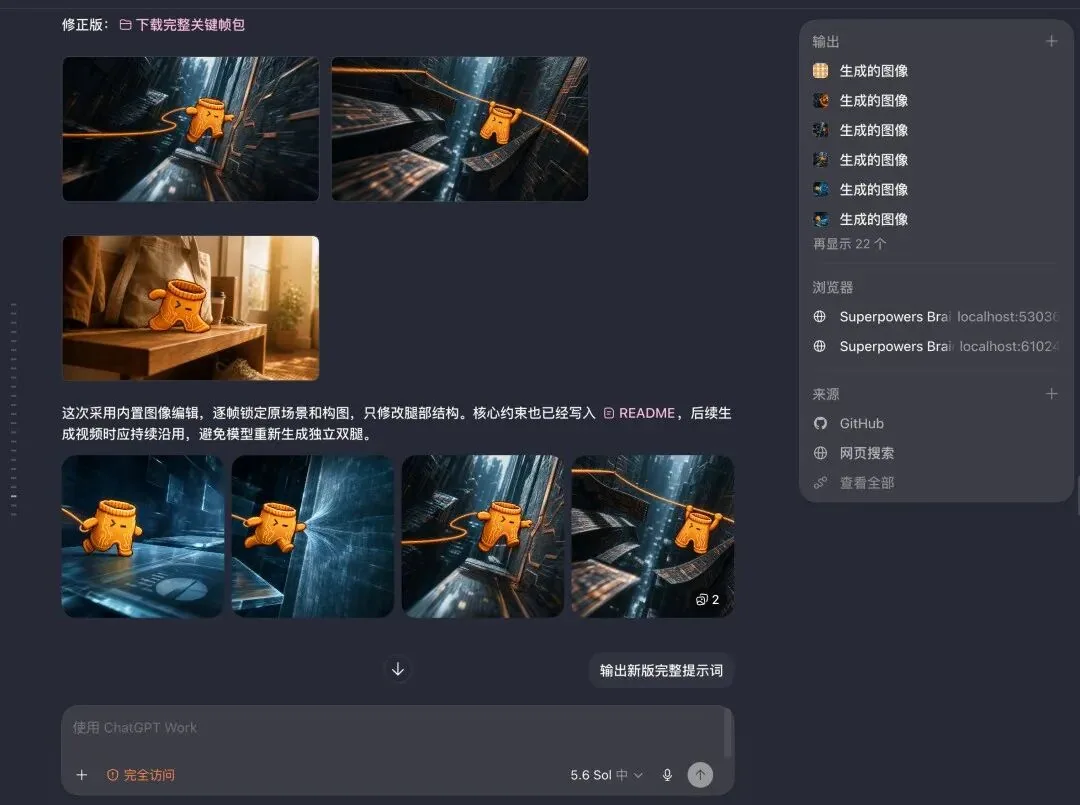
因为现在agent很成熟了,所以可以用比如ChatGPT这种高性价比agent工作台,新建一个线程,图文并茂地一站式产出片子的整体立意、基础设定、分镜、视觉、音轨和字幕策划。
用ChatGPT做策划的好处挺多,比如可以边聊边同步生成关键帧/分镜、智能/策划深度多档可选、有长期记忆便于持续深化等等。
比如最近5.6 Luna大降价,所以就可以选5.6 Luna + 最高推理强度 + 1.5倍速这种组合,以极低的价格获得极佳的体验。
把ChatGPT作为大部分工作的工作台和中枢,是我目前比较推荐的,它的性价比和兼容性都很好。
当然,用Workbuddy逻辑也差不多,可以在核心创意阶段用比较贵的K3,深化阶段换成便宜模型,可玩性和体验也不错。
所以目前的模型+agent用法,是核心工作上高配模型(5.6 Sol / Opus 5 / K3之类),非核心工作用中低配模型(5.6 Luna / Deepseek V4 / Hy3之类),推理强度也相应调整,从而形成模型路由,以实现更高的性价比。
对了,Hy3作为比较靠谱的小参数agent模型,它的免费期又延长了,能用到8月底了。
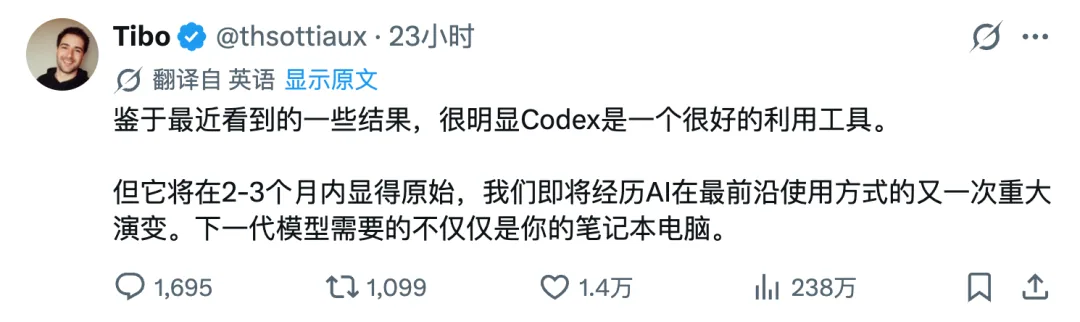
按Tibo的说法,再过两三个月,agent将变天。
可以合理推测,目前这些类似来回切换模型、做“人肉路由”的事情,那个时候可能也就不需要人来做了。
今年秋天的时候,可以期待一个全新的、有更强环境感知和更高自主性的agent形态。
MiniMax Hub做导演和执行
MiniMax Hub是MiniMax新出的一个桌面端多媒体创作agent,跟主打work的MiniMax agent还是有所区别。
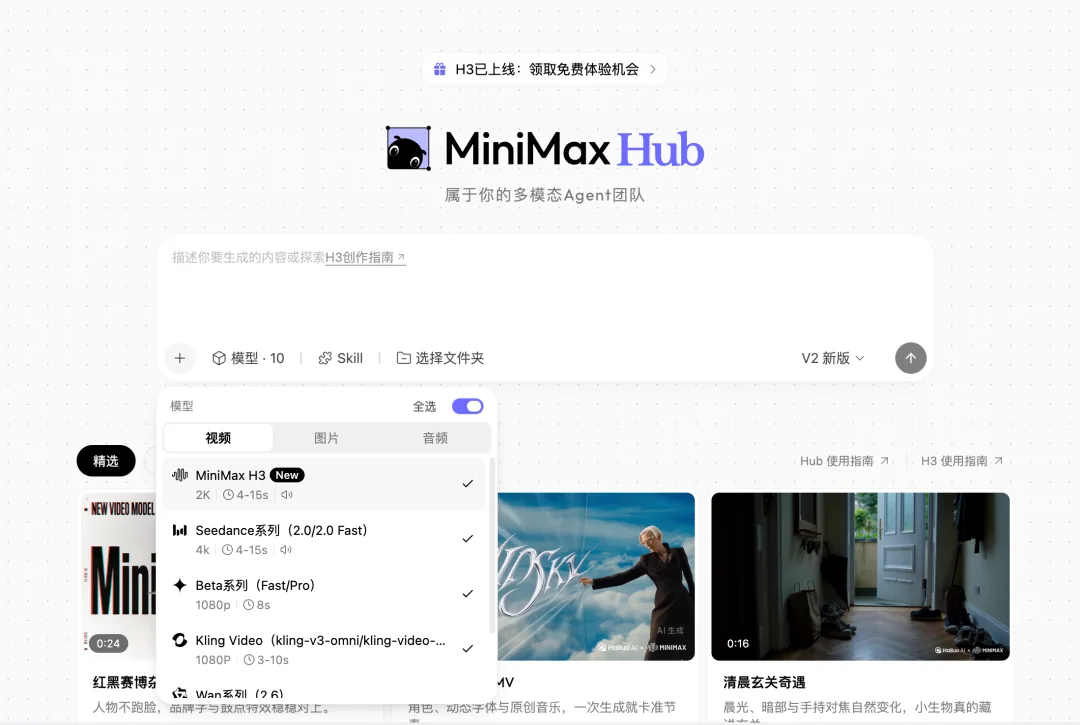
这个agent,集成了H3、Seedance2.0、可灵、阿里Wan这些主流视频模型,还有 Image2、Banana2、Seedream5这些主流图像模型,也根据大家习惯的视觉创意需求,做了agent harness框架优化,综合体验我觉得好于Miora。
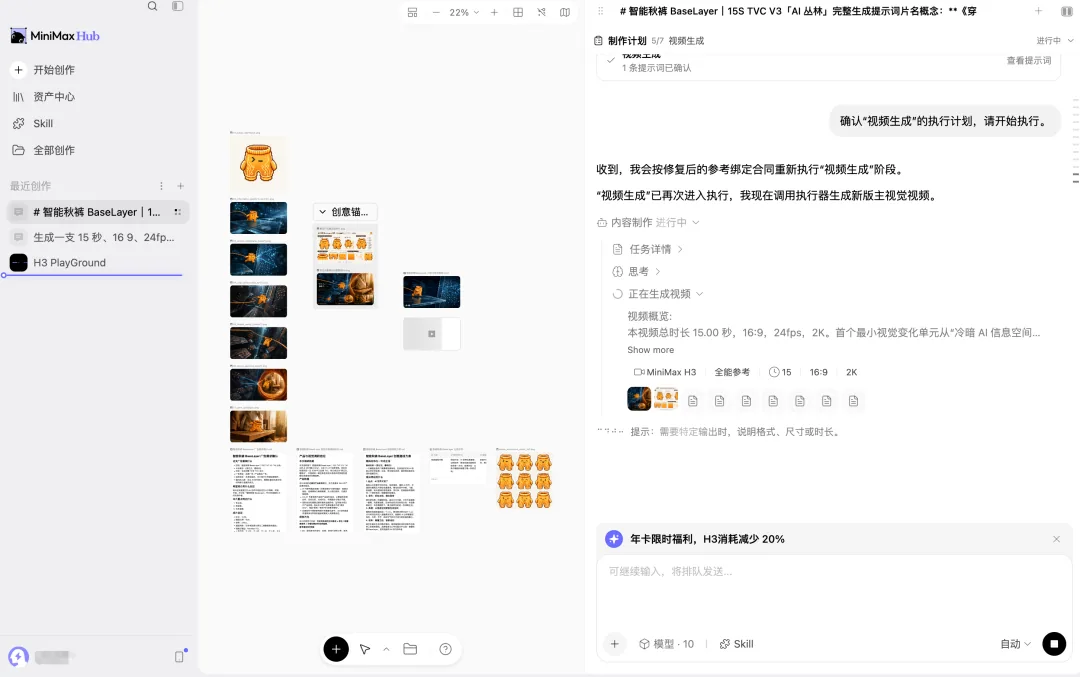
但是,就MiniMax Hub和目前许多类似的创意类agent而言,在他们开始干活后,也就是进入智能代理工作流后,你能感觉到还是有token的浪费,也就是有把ChatGPT已经做好的提示词和关键帧重新加工一遍的嫌疑,有点画蛇添足。
当然,这本质是一个多agent协作衔接的问题,不是啥大事,衔接造成的浪费也有我的原因。
一些体感
这次这个视频还是浪费了不少token,效果也一般,但还是换来了些体感。
比如对于H3这类模型,一次性拉满时长、生成15S视频时,即便提示词和关键帧给的再完备,它还是会多少自作主张和产生失真与BUG,比如有一次结尾时直接搞出了两个秋裤,还有很多肢体神态也很僵硬。
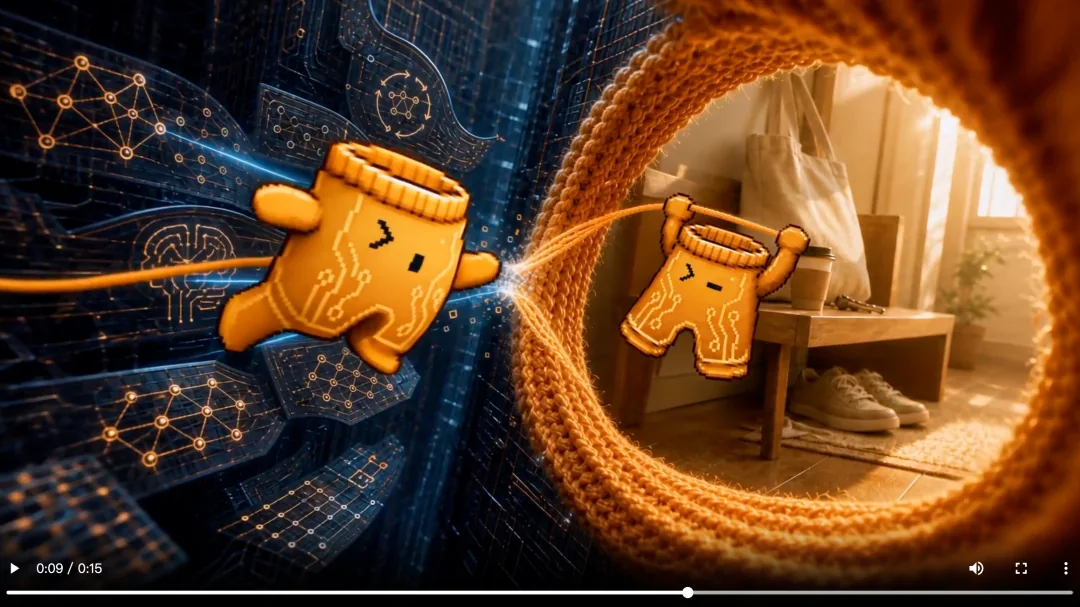
然后我在GPT的指导下优化了策略,改成多镜头分别生成(成本上升),画面控制就好了很多。
还有个心得,是GPT已经可以读取视频并给出优化建议,所以不光是让它出策划,过程中视频怎么改也可以问它意见。
其实我挺期待OpenAI重启Sora的,因为现在ChatGPT/Codex已经把桌面工作台搭好了,再加个自家的视频模型进来,就直接把市面上视频类agent的活也干了,妥妥滴一站式AI工作台。
基于GPT的策划,在MiniMax Hub里交互修改了四五轮,干了大概三四个小时,这个秋裤小视频就做好了。
因为现在agent足够强了,很多剪辑工作都能做,所以可以在agent阶段直接加字幕等包装。当然,也可以把音轨和字幕这些事留到剪映阶段手工解决,其实都行,更多取决于你的手感和偏好。
换句话说,agent和剪映都在向对方靠拢,“agent剪映化”和“剪映agent化”这两件事应该会同时发生。
这次做下来还有个感受,就是在我的懒与agent的勤之间,还是有衔接问题。比如太细的分镜调整,我会倾向于直接点OK,直接信任agent的判断,但这同时也会造成一定的bug和反复。
而agent工作过程中,还是会反复汇报和寻求人类的确认,一方面是为了减少修改反复,另一方面也是向人类转移一部分责任(内容层面的、token费用层面的),也可以理解。
所以现阶段,人机协同的本质还是一个边界拉扯和取平衡的问题,但未来大概率是人类放手、AI包办。
其实这个视频我最早是想用即梦做,但奈何Seedance2.5还是小贵,试了两把就没积分了,就转投H3了。但该说不说,H3试下来,感觉还是略逊于seedance,所以部分镜头我还是用回了seedance。
马斯克的Grok Imagine最近一直想蹭中国模型热度,这个传统从马斯克年初迷恋AI美女那阵就开始了。
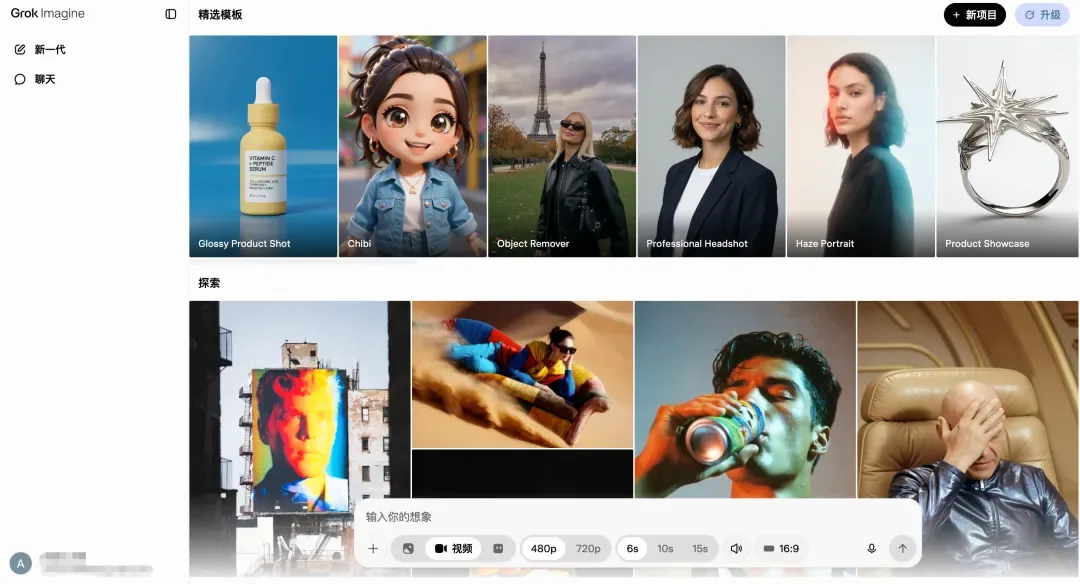
Grok Imagine目前也支持了15S视频生成,但要充值才能用,包括720P也是。
MiniMax H3也是最长支持15S,相较之下,Seedance2.5的常规30S、部分模式下180S可以说遥遥领先了。
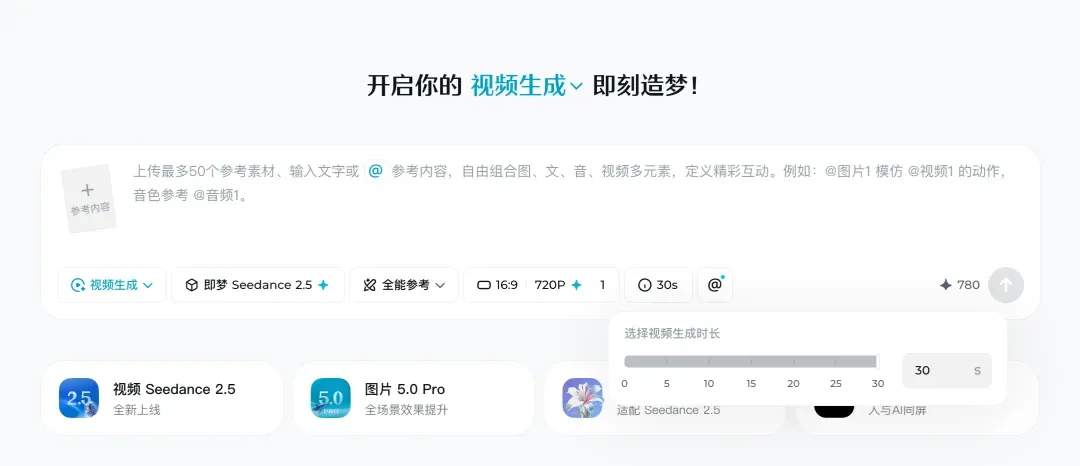
目前给Seedance喂参考视频就有打折,应该是字节在搜集训练数据,也是AI左脚踩右脚的表现之一。
综合能力、价格、体验而言,目前Seedance2.5(720P)和2.0(能做4K)应该是独一档的存在,B端大客户走字节API付费,已经可以极大地降本增效了。
目前电商场景应该已经AI化了,下半年大量的工作场景也会因为AI视频爆发受益,甚至具身智能的技术突破可能也会因AI视频而加速,我们拭目以待。
个人玩家的话,玩玩H3也不错,高性价比的2K视频模型。65元的MiniMax Media Plan基础档大概能做四五条15S的短片,而499元档已具备入门级生产力,我都想给秋裤做短剧了
AI必然成为空气一样的存在,透明到你不会在意。
重要的,是提前开始深呼吸。