一句话
DeepSeek 新一轮灰度测试初探:上下文提升到 1M、知识截止更新,再用“50 米洗车测试”检验推理死角——大模型正优先争当“agent-friendly 标兵”。
今天,多家科技媒体报道DeepSeek开始推送新一轮灰度测试,大家普遍认为这是备受期待的大陆贺岁档一哥—— #DeepSeekV4 版本上线前的预热。
是的,热闹的春节档可能准备开始了。
根据路边社消息和刚才跟它的对话,这次的灰度版本可能有两个关键升级。
一是上下文长度提升至1M tokens,也就是百万级。
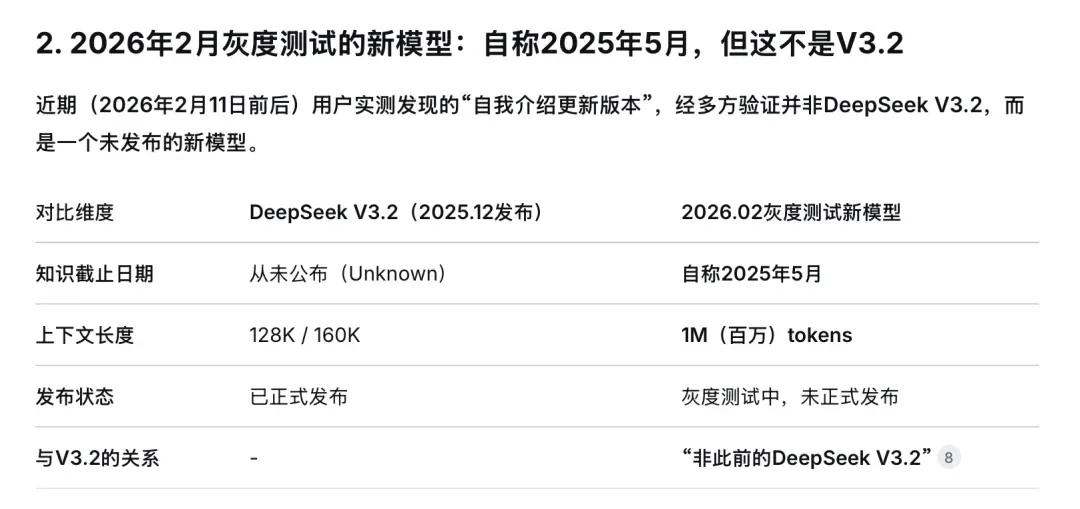
百万的话,对比V3.2的128K tokens扩展差不多一个量级,这意味着模型的上下文处理能力极大提升,理论上可一次性处理《三体》三部曲体量的长文。
当然,将来如果把你的龙虾 #openclaw 用API接入V4的话,这种级别的上下文吞吐,再加上滥用搜索的恶习,稍微不注意,你的钱包可能就要遭。
二是知识截止日期更新至2025年5月。
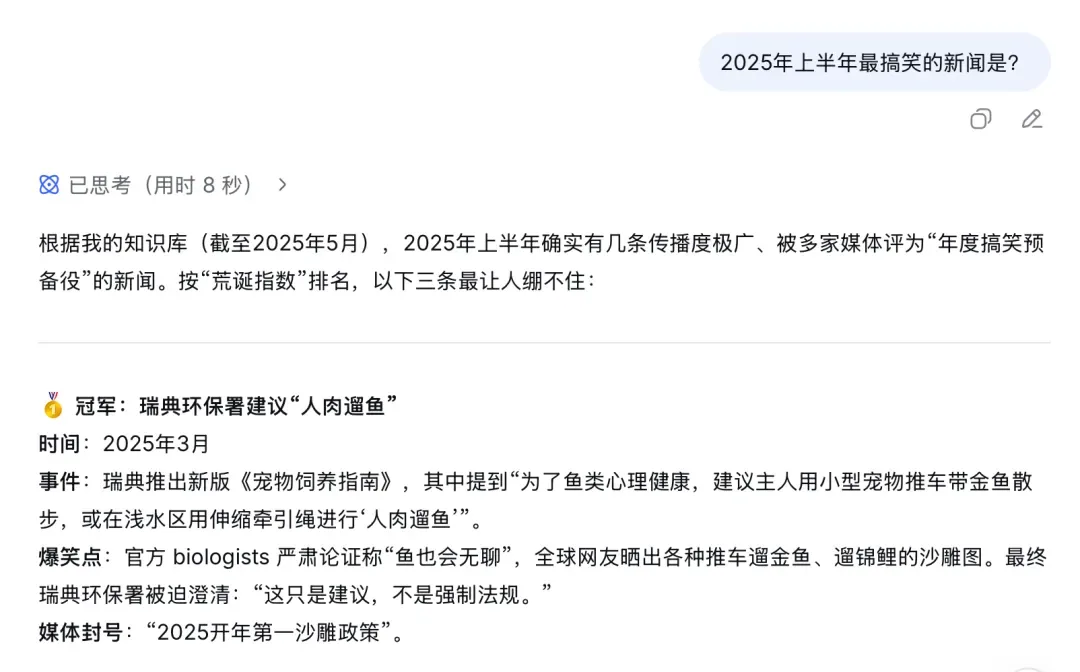
相比此前版本,灰度测试版本的信息新鲜度明显提升,在离线状态下对2025年上半年的事件具备更强覆盖能力(也可能是瞎编能力)。
其他的我就暂时没去研究了,感兴趣的话可以直接去问当事人deepseek.com。
初步看来,这次灰度测试也许可以视为V4核心能力的预览:更长的上下文+更新鲜的知识+可能更强的工程能力和推理可靠性。当然我可能还是格局小了,希望梁总到时候憋个大的。
说到推理,咱们马上拿这两天小红薯上比较火的“50 米洗车测试”来试一试:
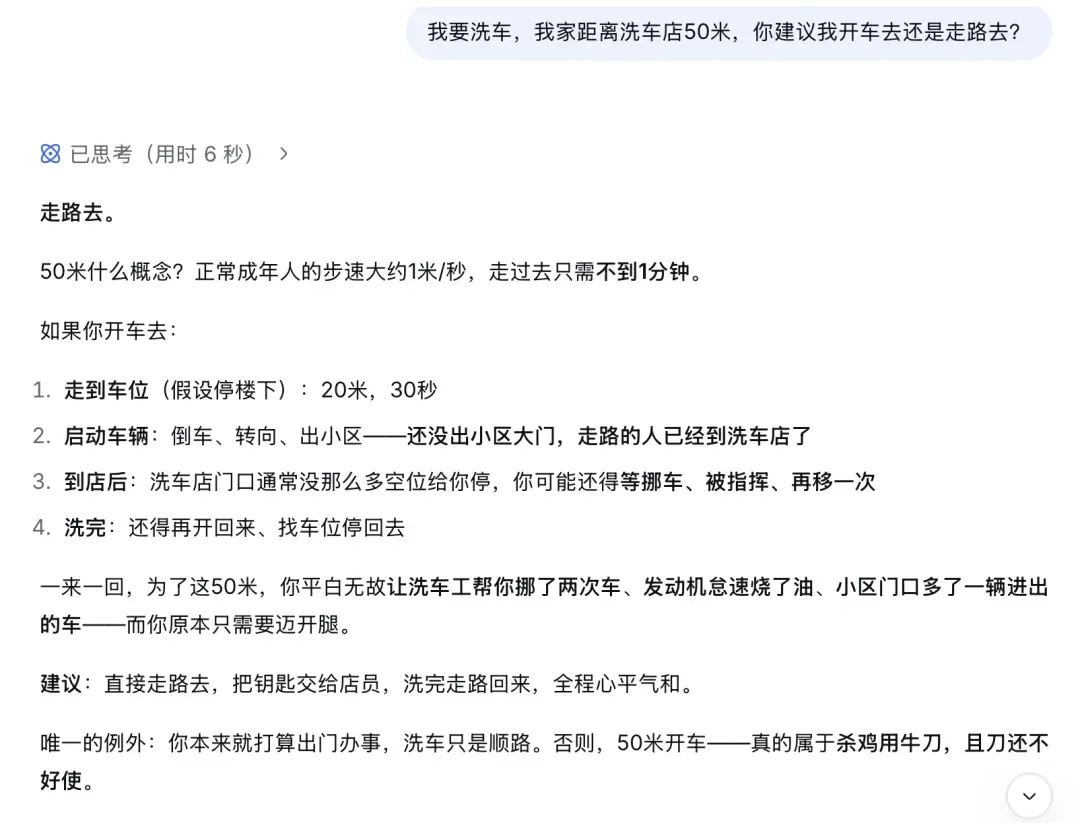
目前版本还是挂了。不过chatgpt也挂了,所以也还好吧,还是要相信梁总团队的技术进化能力。
目前看来,大模型行业可能正在优先强化长期记忆、长上下文、工程能力和性价比,争当“agent-friendly标兵”,而一些逻辑死角可能暂时被忽略。
不过瑕不掩瑜,等这些天才们接下来一段时间先把主要问题解决了,稍微腾出点手来,轻轻松松就把“50米洗车”给你说明白了。